作者归档:uobo

实现全球收款,免费开通万事达虚拟卡

当前国内的形势下,个人开发者的路是被一步步封死了,前些天小米商店好像开始限制个人开发者去上架作品。

因此,在平日里宇翔也接触到一些程序员同行,都将目光投向全球,希望能够开发一款优质的产品来赚取美元。

最典型的案例就是开发独立站进行引流,赚取谷歌的广告费。但是,谷歌的广告费打到自己的账户里面,提现又成为了麻烦事,需要开通各种各样的卡。

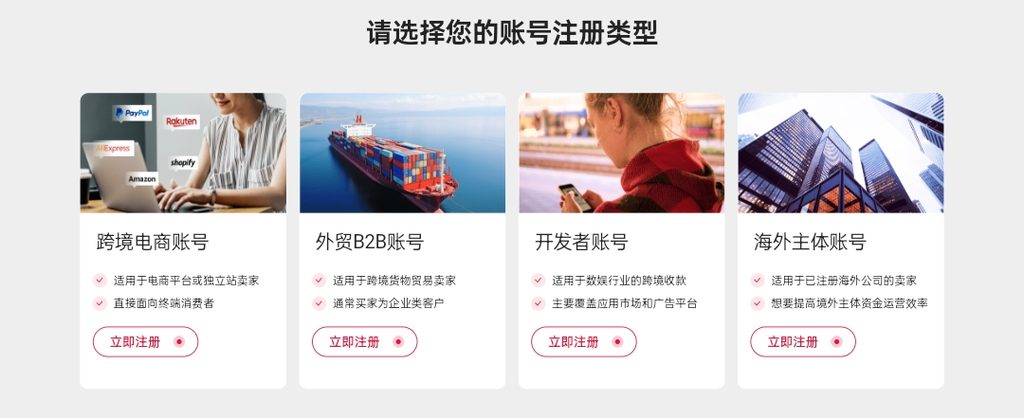
现在的就是万里汇突然放开了限制,增加了一个开发者入口,可用于数娱行业的跨境收款。

刚才去试了一下,目前使用内地身份证、内地手机号、自己实名认证的支付宝即可快速注册通过,中间审核过程几乎没有,都是秒审核秒通过。

目前支持多个收款平台,比如,Google Adsense、Google Admob 等等,后续有可能会慢慢放开其他平台,先注册一个,占一下坑。

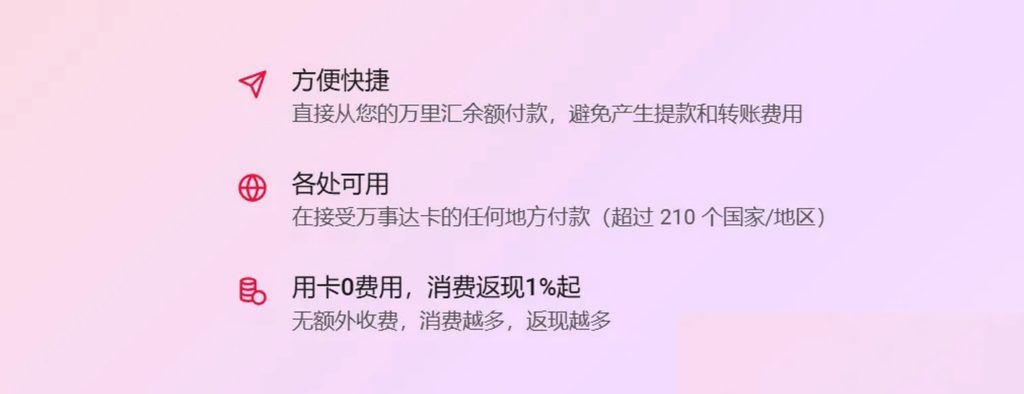
开通后,里面有一个万里付卡 World Card,属于一张虚拟卡,用卡 0 费用,可支持接受万事达卡消费的任何地方,超过 210 个国家/地区,消费还返现。

来自全球的主流货币都是支持的。

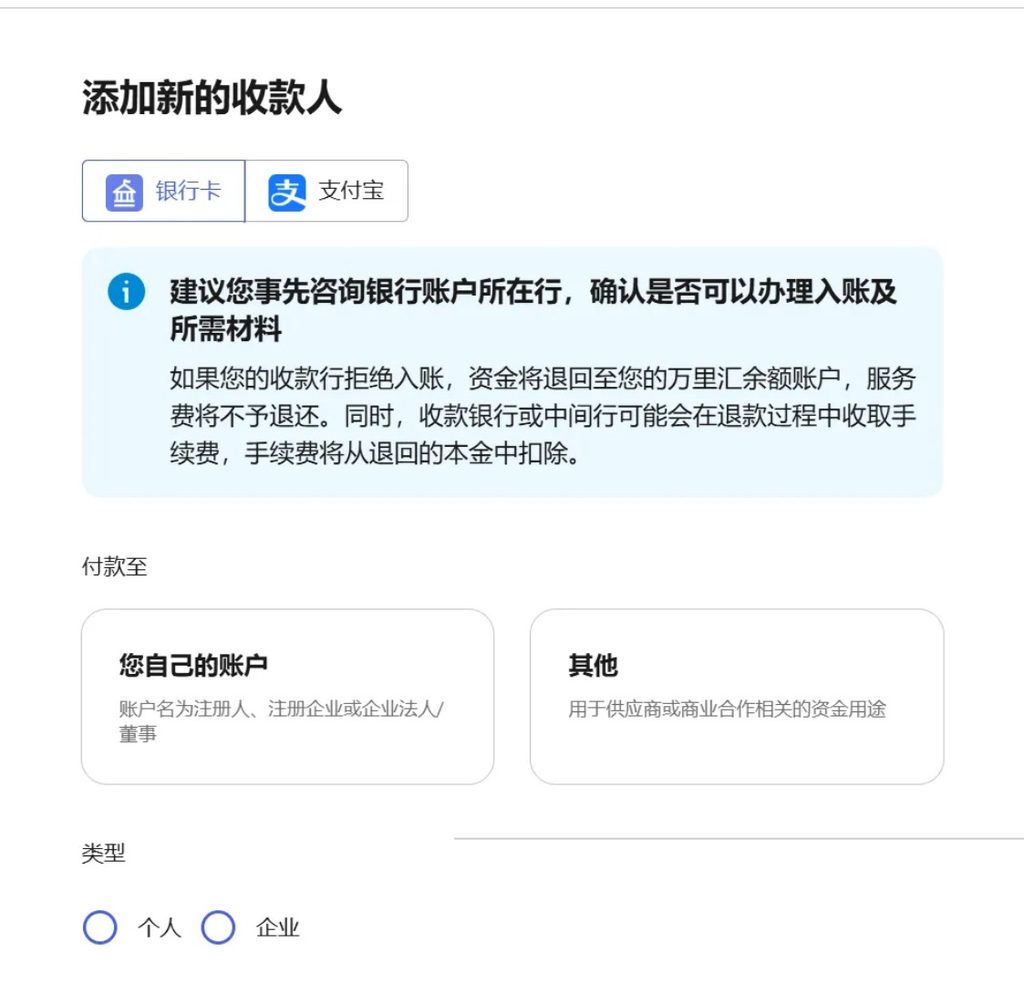
更加关键的一点在于,万里汇是蚂蚁旗下的产品,可完美支持将款打入到国内的支付宝账户,从收款到打款,过程非常顺畅。

这个入口好像是今天才放开的,目前来说审核不严,平台也是让更多开发者能够入驻到这里,所以审核非常宽松,基本一申请就通过。

后面人越来越多,政策也变得越来越严格,基本上任何平台都是这样的发展趋势,早就是优势,建议早点入。

注册地址:https://s.worldfirst.com.cn/3M7iMD?default_source=WF-Vk00000xOfRS&referral_id=WF-Vk00000xOfRS

Python100 天极简打卡清单(每日仅核心任务,直接照着练,每天 30–60 分钟)

前置准备(第 0 天,不计入 100 天)

  1. 安装 Python3.10+、VS Code,配置运行环境
  2. 新建代码存放文件夹,学会新建 / 运行 py 文件、看懂报错

第一阶段:基础语法 Day1–Day30

第 1 周 Day1–Day7

Day1:print、注释、变量、字符串拼接;实操:打印个人信息 Day2:数字运算、int/float;实操:简易两数计算器 Day3:input 输入、类型转换;实操:BMI 计算器 Day4:布尔、比较运算符;实操:成绩是否及格判断 Day5:if/else;实操:分数两级评级 Day6:if elif else;实操:月份判断四季 Day7:综合实战:单次机会猜数字游戏

第 2 周 Day8–Day14

Day8:for+range;实操:1~100 求和 Day9:for 遍历字符串;实操:统计文字字符数 Day10:while 循环;实操:倒计时工具 Day11:break、continue;实操:筛选 1–100 偶数 Day12:嵌套循环;实操:打印九九乘法表 Day13:random 随机库;实操:随机抽奖 Day14:综合实战:完整版猜数字(多次机会 + 大小提示)

第 3 周 Day15–Day21

Day15:列表索引、切片;实操:好友名单管理 Day16:列表增删改查 append/pop;实操:简易通讯录 Day17:列表排序 max/min;实操:成绩单排序 Day18:列表推导式;实操:快速筛选数字 Day19:元组 tuple;实操:存储固定城市数据 Day20:字符串 split/replace/strip;实操:清理文本空格符号 Day21:实战:批量文本分割清理工具

第 4 周 Day22–Day30

Day22:字典基础;实操:姓名 – 成绩字典存储 Day23:字典 keys/values/items;实操:完整学生档案 Day24:集合 set 去重;实操:去除文本重复词语 Day25:def 函数、return;实操:封装 BMI 计算函数 Day26:函数各类参数;实操:封装成绩评级函数 Day27:全局 / 局部变量;实操:多函数数据传递 Day28:try except 异常捕获;实操:防输入崩溃计算器 Day29:import math/random;实操:多功能数学工具 Day30:阶段大项目:本地通讯录(增删查改存数据)

第二阶段:文件 & 办公自动化 Day31–Day60

第 5 周 Day31–Day37

Day31:txt read 读取;实操:读取本地文本 Day32:write/a 追加写入;实操:简易记事本 Day33:readlines 逐行读;实操:读取账单文本 Day34:with 语句;实操:安全读写文件 Day35:os 查看目录文件;实操:读取文件夹所有文件名 Day36:os 新建 / 删除 / 重命名;实操:批量修改图片名称 Day37:实战:下载文件夹自动分类脚本

第 6 周 Day38–Day44 openpyxl 操作 Excel

Day38:安装 openpyxl,新建表格写入数据 Day39:读取 Excel 单元格;实操:提取表格成绩 Day40:批量写入多行;实操:字典数据存入表格 Day41:插入 / 删除表格行;实操:清理无效表格数据 Day42:设置字体边框;实操:美化统计表格 Day43:条件筛选表格数据;实操:提取及格学生 Day44:实战:成绩自动统计(总分 / 平均分 / 排名)

第 7 周 Day45–Day51

Day45:glob 批量匹配文件;实操:批量读取所有 txt 账单 Day46:csv 文件读写;实操:处理逗号分隔台账 Day47:datetime 时间库;实操:日期命名文件 Day48:pathlib 路径处理;实操:自动读取桌面路径 Day49:批量文本替换;实操:批量修改文档指定文字 Day50:zip 压缩解压;实操:批量打包文件夹 Day51:实战:多 Excel 台账合并工具

第 8 周 Day52–Day60 综合小项目

Day52、53、54:项目 1:本地记账软件(存收支 + 月度统计) Day55、56、57:项目 2:桌面文件一键整理工具 Day58、59、60:项目 3:Excel 数据清洗工具(去空值 / 重复)

第三阶段:数据分析 + 进阶语法 Day61–Day85

第 9 周 Day61–Day67 Pandas 数据分析

Day61:Series 一维数据;实操:单列成绩分析 Day62:DataFrame 表格;实操:读取 Excel 生成数据表 Day63:条件筛选数据;实操:筛选指定条件人员 Day64:fillna/dropna 缺失值处理 Day65:sort 排序、groupby 分组统计 Day66:新增计算列;实操:表格自动算总分评级 Day67:实战:自动导出统计分析报表

第 10 周 Day68–Day74 面向对象 OOP

Day68:class 类、实例化;实操:学生类定义 Day69:__init__构造函数、实例属性 Day70:实例方法;实操:学生信息打印、成绩计算 Day71:类继承;实操:教师类继承人员基础属性 Day72:封装私有变量;实操:保护隐私数据 Day73:__str__魔法方法;实操:打印对象可读信息 Day74:实战:面向对象重构通讯录程序

第 11 周 Day75–Day85 标准库 + 合规爬虫

Day75:json 读写;实操:本地存储配置信息 Day76:自定义异常;实操:完善工具报错提示 Day77:re 正则;实操:提取文本数字、手机号 Day78:requests 获取静态网页源码 Day79:BeautifulSoup 网页解析文本 Day80:爬虫延时、合规抓取规范学习 Day81:实战:公开榜单存入 Excel Day82:threading 多线程基础;实操:多文件并行读取 Day83:lambda、map、filter 高阶函数 Day84:生成器迭代器;实操:分批读取海量数据 Day85:阶段项目:榜单采集 + pandas 汇总分析工具

第四阶段:综合实战 + 复盘结业 Day86–Day100

Day86、87、88、89:项目一:一体化办公自动化工具(分类文件 + 合并表格 + 数据清洗 + 报表导出) Day90、91、92、93:项目二:本地台账管理系统(OOP 开发,增删改查 + 导出 Excel) Day94、95、96、97:项目三:公开静态数据采集、清洗、简易可视化统计工具 Day98:全阶段复盘,整理个人代码笔记,标记高频易错点 Day99:薄弱模块专项刷题(循环 / 字典 /pandas 三选一) Day100:结业大作业:自选需求独立完成完整可运行脚本;归档 100 天全部代码

每日执行铁律(打卡必看)

  1. 当天任务当天写完,禁止只看视频不敲代码
  2. 禁止直接复制完整代码,思路参考,逐行手动敲
  3. 报错先自行调试 5 分钟,再搜索解决方案
  4. 断更超过 3 天,先复盘最近 7 天内容再继续
  5. 每周日额外 30 分钟:回顾本周代码,记录踩坑点

100 天 Python 完整学习计划(零基础,工作完全不用编程也能落地)

整体分 4 大阶段,每天30~60 分钟,核心逻辑:语法为辅、实操为主、每天写代码,全程不用复杂设备,电脑安装 Python+VS Code 即可。 适用人群:零基础、无工作编程场景、想靠自学掌握 Python 自动化 + 数据分析基础,100 天后能独立写实用脚本处理表格、文件、数据。

前置准备(1 天,第 0 天,不计入 100 天)

  1. 安装 Python3.10+、VS Code,配置运行环境;
  2. 学会新建 py 文件、运行代码、看懂基础报错;
  3. 准备文件夹:每日代码、练习素材(Excel、文档、图片)。

第一阶段:基础语法入门(Day1~Day30,共 30 天)

目标:掌握全部基础语法,能写简单逻辑脚本,每天固定 20 行以上代码,杜绝只看视频。

第一周 Day1~Day7 最核心极简语法

Day1:print 输出、注释、变量、字符串拼接;实操:打印个人信息、文本拼接小工具 Day2:数字运算、加减乘除取余、数据类型 int/float/str;实操:计算器小程序(两数加减乘除) Day3:输入 input ()、类型转换;实操:输入身高体重计算 BMI Day4:布尔值、比较运算符 > < == !=;实操:判断成绩是否及格 Day5:if /if else 分支判断;实操:分数评级(优秀 / 良好 / 及格 / 不及格) Day6:if elif else 多分支;实操:根据月份判断季节 Day7:本周综合实战:简易猜数字小游戏(单次机会)

第二周 Day8~Day14 循环结构

Day8:for 循环、range ();实操:打印 1-100 所有数字、求和 1~100 Day9:for 循环遍历字符串;实操:统计一句话里字符数量 Day10:while 循环;实操:倒计时小程序 Day11:break、continue 跳出循环;实操:筛选 1-100 偶数 Day12:嵌套循环;实操:打印九九乘法表 Day13:随机库 random 基础;实操:随机抽奖小程序 Day14:综合实战:完整版猜数字游戏(多次机会、提示大小)

第三周 Day15~Day21 列表、元组

Day15:列表创建、索引、切片;实操:储存好友名单,增删查看 Day16:列表增删改查 append/pop/del/insert;实操:简易通讯录增删人 Day17:列表常用函数 len/max/min/sort;实操:成绩单排序、找最高分最低分 Day18:列表推导式;实操:快速生成筛选数字列表 Day19:元组 tuple 特性、不可修改;实操:储存固定不变数据(城市、日期) Day20:字符串全套方法 split/join/strip/replace;实操:批量清理文本空格、分割文字 Day21:实战:文本批量处理工具(分割文本、去多余符号)

第四周 Day22~Day30 字典、函数、异常捕获

Day22:字典 dict 键值对、取值赋值;实操:学生姓名 – 成绩字典 Day23:字典增删改查 keys/values/items;实操:完整学生信息档案 Day24:集合 set 去重;实操:一段文字去除重复词语 Day25:函数 def 定义、参数、返回值 return;实操:封装 BMI 计算函数 Day26:函数默认参数、位置参数、关键字参数;实操:封装成绩评级函数 Day27:局部变量、全局变量;实操:多函数数据共享练习 Day28:try except 异常捕获;实操:输入数字报错不崩溃 Day29:模块导入 import(math、random);实操:数学计算工具 Day30:30 天大综合实战:简易本地通讯录(增、删、查、改、退出)

第二阶段:文件操作 + 办公自动化(Day31~Day60,共 30 天)

重点解决你「工作用不到 Python」的痛点,全部是能直接处理电脑文件、Excel 的实用工具,每天产出可用脚本。

第五周 Day31~Day37 文件读写

Day31:txt 文件打开读取 read ();实操:读取本地文本内容打印 Day32:write 写入、追加 a 模式;实操:简易记事本(写入文字保存本地) Day33:按行读取 readlines;实操:逐行读取账单文本 Day34:with 自动关闭文件;实操:安全读写文本工具 Day35:os 模块基础:查看文件列表;实操:读取文件夹全部文件名 Day36:os 创建文件夹、删除文件、重命名;实操:批量修改图片文件名 Day37:实战:下载文件夹自动分类脚本(图片 / 文档 / 安装包分开)

第六周 Day38~Day44 Excel 基础 openpyxl

Day38:安装 openpyxl,新建 Excel、写入单元格;实操:新建空白台账写入数据 Day39:读取 Excel 单元格数据;实操:读取表格成绩并打印 Day40:批量写入多行数据;实操:把字典数据批量存入表格 Day41:修改表格、删除行、插入行;实操:清理表格无效数据 Day42:设置单元格字体、边框;实操:美化简易统计表 Day43:筛选表格数据、按条件提取;实操:提取表格里及格学生 Day44:实战:Excel 成绩自动统计工具(算总分、平均分、排名)

第七周 Day45~Day51 批量办公工具开发

Day45:glob 批量匹配同类型文件;实操:批量读取全部 txt 账单 Day46:csv 文件读写;实操:处理逗号分隔台账 Day47:时间模块 datetime;实操:自动记录文件修改时间、生成日期命名 Day48:路径处理 pathlib;实操:自动获取桌面、文档绝对路径 Day49:文本批量替换、批量删除指定内容;实操:批量修改所有文档固定文字 Day50:压缩解压 zip 文件;实操:批量打包多个文件夹 Day51:实战:台账合并工具(多个 Excel 表格合并为一张总表)

第八周 Day52~Day60 阶段综合项目

Day52-54:项目 1:本地记账软件(读写 txt 保存收支,统计月度总额) Day55-57:项目 2:文件整理工具(一键分类桌面杂乱文件、重命名) Day58-60:项目 3:数据清洗工具(清洗 Excel 重复、空值、错误数据并导出新表)

第三阶段:数据处理与进阶语法(Day61~Day85,共 25 天)

目标:掌握数据分析基础、面向对象、爬虫基础(合规静态页面),逻辑能力大幅提升。

第九周 Day61~Day67 Pandas 数据分析入门(最实用)

Day61:安装 pandas,Series 一维数据;实操:单列成绩分析 Day62:DataFrame 二维表格;实操:读取 Excel 生成数据表 Day63:数据筛选、条件查询;实操:筛选工资大于 5000 人员 Day64:缺失值处理 fillna/dropna;实操:清除表格空白数据 Day65:数据排序、分组 groupby;实操:按班级分组统计平均分 Day66:数据计算、新增列;实操:表格新增总分、评级列 Day67:实战:完整 Excel 数据分析报表,自动导出统计结果

第十周 Day68~Day74 面向对象 OOP

Day68:类 class、实例化;实操:定义学生类 Day69:构造函数__init__、实例属性;实操:创建多个学生信息 Day70:类方法、实例方法;实操:学生自我介绍、计算成绩 Day71:继承、父类子类;实操:教师类继承人员通用属性 Day72:私有变量、封装思想;实操:保护隐私数据不随意修改 Day73:魔法方法 str;实操:打印对象显示可读信息 Day74:实战:用面向对象重构之前的通讯录项目

第十一周 Day75~Day85 标准库 + 合规静态爬虫

Day75:json 数据读写;实操:本地 json 存储配置信息 Day76:异常进阶、自定义错误;实操:完善工具报错提示 Day77:正则表达式 re 匹配文字;实操:提取文本手机号、数字 Day78:requests 库基础,获取静态网页源码(仅公开无反爬静态页) Day79:BeautifulSoup 网页解析;实操:提取页面标题、文本 Day80:爬虫规范、延时、禁止高频抓取;学习合规边界 Day81:抓取公开静态榜单存入 Excel;实操:本地榜单表格 Day82:多线程基础 threading;实操:多文件同时读取提速 Day83:函数高阶用法:匿名 lambda、map、filter Day84:生成器、迭代器;实操:海量数据分批读取不卡顿 Day85:阶段大项目:公开榜单爬虫 + pandas 数据分析汇总工具

第四阶段:综合实战 + 查漏补缺(Day86~Day100,共 15 天)

不再学新零散知识点,全部独立完成完整项目,复盘前 85 天薄弱点,形成完整作品集。 Day86~Day89 项目一:自动化办公一体化工具 功能:文件分类、多表格合并、数据清洗、自动生成统计报表、导出 Excel

Day90~Day93 项目二:本地数据管理系统(面向对象开发) 功能:人员 / 台账增删改查、数据持久化保存、条件筛选、导出表格

Day94~Day97 项目三:数据采集分析工具 功能:静态公开页面数据抓取、正则清洗、pandas 统计、可视化简单图表

Day98:全知识点复盘:整理自己的代码笔记,标记经常报错的语法 Day99:查漏补缺:针对自己最薄弱模块(循环 / 字典 /pandas)集中刷题 2 小时 Day100:结业大作业:自选需求独立完成一个完整可交付脚本,整理全部 100 天代码文件夹

硬性执行规则(决定你能不能学完 100 天,必看)

  1. 每天必须手写代码,禁止复制粘贴完整代码;看不懂可以看思路,逐行手动敲
  2. 当天知识点当天练完,绝不堆积;中断超过 3 天从头复习最近一周内容
  3. 无工作场景就强制每天用脚本解决电脑上一件琐事(整理文件 / 处理表格),制造使用场景
  4. 报错优先自己翻译提示调试 5 分钟,实在无解再搜索,不直接抄答案
  5. 每周日复盘 30 分钟:回顾本周代码,记录易错语法,简单做笔记

100 天后达成水平

  1. 熟练 Python 全套基础语法,独立看懂普通源码;
  2. 熟练自动化处理 Excel、本地文件,批量处理表格、文档、文件夹;
  3. 会用 Pandas 做基础数据清洗、统计分析;
  4. 能写合规静态页面简易爬虫抓取公开数据;
  5. 掌握面向对象编程,能独立开发完整小型工具程序;
  6. 拥有 10 + 可直接使用的自制脚本,形成个人代码作品集。

自己学不会python可能原因

90% 普通人学不会 Python,根本不是环境、脑子、天赋问题,核心是「没有持续使用场景 + 学习方法完全错了」。 你说的 “工作生活用不上” 是最大阻碍,但只是表层原因,深层有多层叠加问题,我一条条给你拆开,同时给可落地解决办法。

一、你说的:工作生活完全用不到 Python(最大客观障碍)

为什么没场景就学不牢?

编程和学车、学英语一模一样:

  • 只看书 / 看视频 = 纸上谈兵,看完 3 天全忘;
  • 没有固定需求倒逼你写代码、排错、反复调试,大脑不会形成长期记忆。

比如: 上班族每天下班学 1 小时,学完关电脑,一周内没有任何事需要用循环、字典、函数; 下一次打开教程,前面的语法全模糊,永远卡在入门阶段,反复循环 “学了忘、忘了学”。

分两种人群现状

  1. 文职 / 车间 / 乡镇 / 普通行政:日常只有 Word、Excel、表格统计,公司无数据分析、自动化需求,没人分配 Python 任务;
  2. 想转行、纯兴趣:身边没人交流,没有项目压力,全靠自制力驱动,很容易半途而废。

二、比 “没工作场景” 更致命的 4 个主观问题(绝大多数人踩坑)

1. 顺序学反了:先啃完整语法,再想做项目

标准错误路线: print→变量→循环→判断→列表→字典→函数→类→模块…… 连续啃半个月语法,枯燥到放弃。 问题:人天生讨厌纯理论,几十种语法细节堆在一起,根本记不住,越学越挫败,产生 “我不适合编程” 的自我否定。

正确逻辑:先会做小事,再补语法。 第一天就写自动化小脚本,遇到不懂的语法当场查,用到什么学什么。

2. 只看视频不敲代码,敲代码不排错

很多人学习模式:倍速看教程,看懂 = 学会,很少动手; 就算动手,一报错就直接搜完整答案复制,不思考报错原因。 编程的核心能力是读报错、调试逻辑,跳过排错环节,永远独立写不出代码。

3. 目标太大,没有微型短期任务

一上来目标:做爬虫、做 AI、做网站、做数据分析系统。 复杂项目包含几十种知识点,新手根本 hold 不住,写两行就卡住,直接摆烂。

4. 缺乏正向反馈,容易自我怀疑

工作不用 Python,写完脚本没人认可、没有实际收益; 遇到 bug 卡几小时解决不了,没有同行交流,孤独学习很容易放弃。

三、区分两种情况:你到底是哪种 “学不成”

情况 A:能看懂代码,但自己从零写不出来(最常见)

根源:只输入不输出,缺少独立构建逻辑的训练,没有固定小事练手。

情况 B:看教程就犯困,坚持不了 3 天,总半途而废

根源:学习路径枯燥,没有即时成就感,缺少外部驱动力。

情况 C:能写简单代码,复杂逻辑完全没思路

根源:跳过基础实操,直接冲击大型项目,基础逻辑训练不足。

四、针对性解决方案:就算工作完全不用,也能学好 Python

方案 1:给自己创造「每日刚需小场景」(解决无环境痛点)

不用等公司给任务,自己制造高频使用需求,每天 10–30 分钟:

  1. 办公自动化(所有人都能用)
    • 批量重命名电脑文件夹里所有文件;
    • Excel 批量整理台账、拆分表格、统计数据;
    • 自动整理下载文件夹,分类图片、文档、安装包;
  2. 生活工具脚本
    • 记账小程序,自动读取账单文件算月度开支;
    • 本地文本工具:批量修改文案、去重复文字;
  3. 低成本爬虫(合规仅限公开静态页面,禁止爬有反爬、隐私、付费网站)
    • 抓取免费公开小说、公开书单、公开天气预报做本地工具。

每天固定一件小事用 Python 解决,替代手动复制粘贴,形成依赖,自然熟练。

方案 2:彻底调整学习顺序,告别枯燥语法

  1. 前 3 天:只学 print、变量、if 判断、for 循环,立刻写 2 个小脚本(批量改文件名、数字求和工具);
  2. 第 1 周:学习列表、字典,做简易通讯录、记账本;
  3. 遇到新语法(函数、文件读写),用到再学,不一次性死记硬背;
  4. 语法书只当工具书,不从头到尾通读。

方案 3:强制动手 + 独立排错训练

  1. 看视频时:暂停,不看教程代码,自己先写一遍,写完再对照;
  2. 报错不直接复制答案:翻译报错提示,自己排查 5 分钟,实在无解再搜;
  3. 禁止复制完整代码,只借鉴思路,手动重写。

方案 4:拆分微小目标,制造即时成就感

不要目标 “半年精通 Python”,换成每日小目标:

  • 今日:完成批量整理文件脚本;
  • 3 天:实现 Excel 自动求和;
  • 一周:做出本地简易记账工具; 每完成一个就能实实在在用上,持续获得正向反馈,不容易放弃。

方案 5:低成本外部驱动力(解决独自学习容易摆烂)

  1. 线上打卡社群,每天上传自己写的小代码;
  2. 把写好的工具分享给朋友用,获得反馈;
  3. 设定微小奖励:完成一周实操,奖励自己休息、娱乐。

五、补充:哪些情况会让你学习效率极低,尽量避开

  1. 每天只看视频、从不实操;
  2. 一卡壳就换教程,来回切换课程,没有持续练习;
  3. 跳过基础,直接学 AI、爬虫、Web 框架;
  4. 三天打鱼两天晒网,一周只学一次,每次两小时,不如每天 20 分钟稳定练习;
  5. 总纠结 “环境不好、工作用不上”,陷入内耗,不主动创造练习场景。

六、总结一句话

工作生活不用 Python 只是客观劣势,但不是学不会的根本理由。 真正阻碍你的是:枯燥的纯语法学习方式、缺少持续实操场景、只看不写、没有短期正向反馈。 只要主动给自己安排每天能用的小脚本任务,坚持动手写、独立排错,哪怕工作完全不涉及编程,半年也能熟练掌握 Python 基础与实用工具开发。

零基础、低成本做动画短片 极简步骤

目标:先做 1‑5 分钟短片,不搞长片,不用团队、不用很贵设备

0、先定最简单方向

优先二选一

  • 2D 扁平动画(门槛最低)
  • 简单 3D(像牛来那种风格会难很多,不建议新手直接冲)

设备:普通家用电脑就可以,手机也能做超短小动画

1 想故事(1 天)

  1. 想好一个很短小故事:谁,发生了一件什么事,最后怎么样
  2. 写超简短剧本,不用复杂台词 举个例子:一只小牛迷路,最后找到了伙伴

2 分镜 / 画草图(1‑3 天)

不用会专业画画,白纸或者平板上简单涂鸦 一格 = 一个镜头:画面里有什么、角色什么动作 不用好看,自己看得懂就行

3 角色 + 场景

  • 2D:画人物、背景;或者用软件自带现成素材
  • 3D:直接用免费模型,不要自己从零建模,新手建模巨耗时间

4 做动画,让画面动起来(最花时间)

免费软件推荐

2D:剪映(关键帧动画,最简单!)、OpenToonz、Blender‑ grease pencil 3D:Blender(完全免费) 操作思路:摆好第一个姿势 → 摆好结尾姿势,软件自动生成中间动作

5 配音、音效、背景音乐

  1. 自己对着话筒配音(手机录音就行)
  2. 找无版权免费音效:风声、脚步声
  3. 配背景音乐,一定要用免费可商用音乐,避免侵权

6 剪辑合成

把所有镜头按顺序拼在一起,加字幕,调时长。剪映就能搞定。

7 导出发布

导出视频,直接发到抖音、B 站等平台。

❗如果只是自己玩、网上发短片,不用备案、不用龙标。只有打算电影院上映才需要审批。

超浓缩 5 步口诀

想故事→画镜头草图→做角色场景→调出动作→配音剪辑导出

做像牛来一样的电影需要哪些步骤?

做《牛来》这种独立 3D 水墨动画长片,极简 7 大步

它是两个人花 5 年电脑手搓出来的 3D 动画,没有实拍演员、摄像机,全程软件做画面

1、写故事 + 剧本

想好讲啥,写出完整台词剧本。国内想院线公映先要剧本备案

2、画人设、场景、分镜

画出小牛、小鸟长啥样、草原环境;再一镜一镜画好:镜头里画面是什么。

3、三维建模(造模型)

电脑里做出小牛、动物、草地山石的 3D 立体模型,相当于搭出来虚拟玩偶和虚拟世界。

4、绑定骨骼 + K 动画(让东西动起来)

给模型装上 “看不见的骨头”,手动一帧一帧调动作:小牛走路、奔跑、转头、表情。 所有画面全靠一点点调,这一步最耗时间。

5、搭场景、打灯光、渲染出画面

建好草原、荒漠这些虚拟环境,调好光影,电脑一点点算出每一帧高清图片。 86 分钟电影,十几万张画面。

6、后期:剪辑、配音、音乐、音效

把镜头拼起来,配人声、背景音乐、风吹、动物叫声,调色。

7、送审拿龙标 + 上映

成片提交审核,拿到公映许可证,才能放到电影院播放。

超级一句话最简版

写剧本→画角色镜头→建 3D 模型→调动作动画→渲染画面→配音剪辑→送审上映

平台时代落幕之后,普通人做内容会变成什么样

现在的内容逻辑:创作者依附平台 APP 生存

视频、文字、粉丝、播放数据,全部存在平台服务器。平台定算法、定审核尺度、定流量,想限流就限流,账号一封,多年积累直接清零。

粉丝名义上是你的粉丝,实际上是平台的用户,你只是借平台触达他们。就算有几十万粉,换一个 APP,几乎带不走。

未来不会直接全部废掉短视频、图文大平台,但它们会从唯一流量游乐场,变成众多分发渠道之一

一、创作者的数字大本营:个人内容站(AI 一键生成)

就像商家的独立店铺,普通人、博主也会拥有属于自己的个人内容主页

  • 域名归自己,文字、视频、相册全部存自己可控存储;
  • AI 自动排版,自动适配手机、眼镜、电脑,不需要懂技术;
  • 粉丝订阅关系掌握在自己手里,不是平台的订阅列表。

这个主页不一定是人天天点开看。它是你的内容源头仓库

你产出一条内容,先发布到自己的大本营,再一键同步分发到各大短视频、社交平台、开放网络。

平台只是 “转发渠道”,而不是内容的出生地。平台限流、封号,你的原作、你的订阅粉丝库不受损失。

二、两种内容分发模式并行

模式 1:传统平台分发(继续存在)

大平台依旧有海量用户,适合想快速博大众眼球、赚平台流量补贴的人。

只是创作者心态变了:把平台当做曝光广告位,而不是自己的根。不在平台里面押上全部积累。

模式 2:AI 智能体做内容发现(最大变革)

现在是人刷 APP,算法喂给你看内容。

未来反过来:人提出兴趣需求,AI 去全网抓取内容

举例子:

用户跟 AI 说:“给我找一些讲乡村基层工作的真实随笔,不要鸡汤,最近三个月更新的。”

AI 不会只搜某一个短视频平台内部。它会遍历:各大平台、无数普通人自建内容站、联邦社区,筛选文字、视频,整理推送给用户。

这时候,流量不再完全靠平台算法宠幸。

你的内容只要源头公开、信息完整,就有机会被 AI 检索、推给感兴趣的人。

但随之而来新内卷:适配 AI 阅读

写文案、做视频的时候,要让 AI 能准确理解你内容讲什么,就相当于早年做网站的 “SEO 搜索引擎优化”,会出现新一代的 AI‑SEO 技巧。

三、账号与粉丝关系的改变

今天:粉丝关注的是「这个平台内的账号」。

未来:粉丝订阅的是创作者本人的身份源,而不是某 APP 账号。

类似邮件订阅:不管你把内容同步到哪个平台,订阅你的人,都可以收到你的更新。就算某个平台把你的账号删掉,你的订阅关系不受破坏。

这里有两条技术路线实现这件事:

  1. 开放联邦协议:很多独立小服务器互通,账号身份跨站点通行,不用在每个平台重复注册账号。缺点对普通老百姓上手有点复杂。
  2. AI 订阅聚合器(大众主流):普通人不需要懂分布式,用一个 AI 助手,统一订阅全网不同创作者的源头,把所有更新汇总到自己这里,相当于新一代 RSS 阅读器,由 AI 增强。

四、收益模式的变化

现在创作者赚钱路径:平台广告分成、平台直播间打赏、平台带货佣金,钱大多经过平台之手,平台抽大头。

以后会分化成多种收益路径:

  1. 依旧走平台:广告、直播带货,接受平台抽成,换取平台的海量曝光;
  2. 直接面向粉丝付费:会员、付费专栏、付费音频课程,支付直接给到创作者,只付少量中立第三方支付服务费,不再被大平台高额抽成;
  3. AI 中介撮合:品牌找创作者,AI 全网筛选匹配创作者,不一定需要经过平台的商单后台;
  4. 打赏可以来自任意渠道,不限于某一个 APP 内。

当然,平台不会消失商单业务,只是不再垄断商单市场。

五、会出现的现实问题,不是理想乌托邦

  1. 噪音和垃圾信息变多 中心化平台有审核;当无数自建站点自由发布内容,谣言、劣质内容会泛滥。 于是 AI 要承担过滤、核验事实的工作,AI 辨别信息真假会变成刚需。但 AI 本身也会出错、会带偏见。
  2. 新的权力转移到大 AI 厂商 如果绝大多数人靠某两三家大模型来找内容,那么大模型就变成新的 “超级平台”,它决定优先推谁、不推谁,形成新一轮垄断。 所以端侧本地 AI、多家模型竞争会非常关键,防止一家说了算。
  3. 信任门槛提高 过去平台帮你背书账号;自建阵地时代,真假博主鱼龙混杂,冒充别人的账号会变多,身份核验、资质证明会变得重要。
  4. 普通人还是怕麻烦 自建内容站、维护自己的订阅库,对很多只想随手拍两条视频的普通人来说,依然有一点点门槛。大部分随手记录的用户,依旧会习惯性选择简单的大平台,图方便省事。

六、分三类创作者的未来处境

①随手记录的普通大众(大多数人)

依旧主要用大平台随手发日常。拍照拍视频,图简单方便。

不会折腾自建站。只是慢慢会有更多备选小平台可以选,不必吊死在一个产品。

②有长期积累的博主、垂直领域创作者(最适合拥抱新方式)

一手内容源掌握在自己手里,多渠道分发。平台用来引流,自有阵地用来沉淀粉丝、做复购、做付费。不怕封号清零。

像做一个属于自己的 “线上出版物”。

③极客、深度内容爱好者

使用联邦网络、分布式服务,账号数据高度自主。受众相对小众。

七、现在普通人可以提前做的小事,不必等未来

  1. 重要的原创素材自己本地备份:视频原片、文稿,不要只保存在平台;
  2. 尽量把核心粉丝的联络渠道掌握一部分,不要只有平台私信;
  3. 如果长期输出内容,可以注册一个简单域名,预留自己的线上身份;
  4. 不要把全部希望寄托单一平台算法,打磨内容本身,未来 AI 检索时代,真实、完整的内容价值会进一步放大。

延伸一点,和上一篇商家部分串起来看

商家管商品,创作者管内容。

大趋势是一样的:

过去:人来到平台里面,看平台的内容,买平台里商家的货。

未来:内容、商品源头散在互联网各处;AI 作为中间人,到全网去找内容和商品,再交付给人。

平台从 “围墙大商场”,降级成互联网里许许多多店铺中的一家。

未来小商家线上生意通俗推演

前提:大平台不会消失,但不再是做生意的必选项。

以后商家手里最重要的不再是平台店铺等级、直通车预算,而是三样东西:自己的域名、自己的客户数据、完整商品资料

一、日常会是什么样子

1. 商家这边

不用雇程序员,AI 工具一键生成自己的独立店铺(网页、小程序、适配手机眼镜都能用)。

商品、库存、客户联系方式、订单全部存在自己可控的云空间,不是存在某电商公司服务器。

好处:不会因为平台改规则、违规误判、限流封号一夜归零;想调价、搞活动完全自己说了算,抽成可以做到极低。

这个独立店不是给人天天手动点开逛,它更像你的数字大本营

你可以选择把店铺同步到大平台、联邦社区做分销引流,也可以不同步。平台此时只是一个引流渠道,不是你的全部底盘。

2. 顾客这边

顾客很少专门点开一个个 APP 刷货,更多直接跟 AI 提需求:

“给我找邢台本地手工挂面,要农户自家做的,性价比高”

AI 智能体会全网检索:大电商平台、各家小商家独立站点、社区内容,自动比价、筛选评价,把结果给到用户。

顾客点进去,直接跳转到商家自家店铺完成下单,不一定经过大平台。

流量逻辑彻底变了:

  • 现在:花钱在平台内部买广告抢排名,你跟同行内卷竞价。
  • 以后:你把商品信息完整、真实地对外开放,AI 能读懂你的店铺,就有机会被检索到。竞价广告依然会存在,但不再是唯一生存手段

二、三种商家的不同生存路线

路线 A:图省事,继续待在大平台(大多数普通商家短期选择)

依旧开店、投流量,接受抽成、规则约束。

区别在于:不再把鸡蛋全放这里。

同时搭建自己的独立小站,把平台来的客户尽量沉淀到自己手里。

平台做获客,自己的阵地做复购。哪天平台政策变差,可以随时撤走核心客户资源。

路线 B:主打自主权,以自建阵地为主(中型、特色、本地化商家)

核心底盘是 AI 生成的独立店铺。

引流靠:AI 检索、社群、本地熟人、短视频内容、少量联邦开放社区。

大平台只当做其中一个分销渠道,有单就做,没单也不影响根基。

适合特产、手作、本地服务、私域复购强的生意。

路线 C:极客型,联邦分布式网络(小众)

加入或者自建开放协议的服务实例,账号、店铺跨服务器互通,没有单一公司管控。

门槛偏高,普通小老板很难玩明白,更多是创作者、小众品牌。

三、会遇到的现实痛点(不会是完美乌托邦)

  1. 流量不会凭空来 就算你有自己网站,也不会自动爆单。只是不再被一家平台锁死;需要做好产品、真实信息,方便 AI 识别抓取。
  2. AI 会成为新关口 如果少数几家大模型垄断全网检索,商家又要开始讨好 AI,做 “适配 AI 的商品信息”,形成新的内卷。 所以端侧本地 AI 会变得重要:多套 AI 可供选择,不被一家拿捏。
  3. 信任和支付问题 平台时代,平台充当担保、售后仲裁。全部自建之后,商家自己要解决信任、售后纠纷、支付对接,对商家的诚信要求更高;也会诞生很多中立第三方小服务商,专门提供支付、售后仲裁、质检,代替大平台的职能。
  4. 监管不会缺位 去中心化不等于无法无天,资质、售后、消费者保护依旧要遵守法规。

四、一条简单的时间感推演

  • 近 5‑8 年:混合过渡期。大平台依旧强势,AI 建站普及,越来越多商家开始搭建自己备用独立站点,AI 检索购物慢慢兴起。
  • 更远周期:平台从 “必经商场” 退化为 “可选商场”,拥有自有数字阵地,成为中小商家的常规操作。

落到现实,普通小商家现在可以提前准备什么,不用等未来到来

  1. 保护好你的客户联系方式,不要全部只存在平台聊天记录里;
  2. 如有条件,可以注册属于自己的域名,提前占住身份;
  3. 完整整理自己产品介绍、实拍素材,这些以后是 AI 识别你的核心资产;
  4. 不要把全部生意押在单一一个平台上。

互联网的演变推演:从自建网站→平台时代→平台之后

  1. 早期 Web1.0:自己建网站。商家、个人买域名、租服务器,自己建站。流量靠搜索引擎,你的客户、内容、店铺属于你自己;缺点是门槛高,普通人玩不转。
  2. Web2.0 平台时代:入驻平台。不用懂技术,注册账号就能开店、发内容。平台提供流量、支付、用户,降低门槛;但代价是:客户不属于你、规则平台说了算、抽成、限流、封号风险,商户相当于租平台的铺面做生意,也就是你说的对商户不友好的根源 —— 平台掌握流量分配权,商业逻辑走向资本最大化,商户变成 “数字佃农”。
  3. 手机不是彻底消灭电脑,只是把主要使用终端转移;同理,平台不会一夜彻底消失,但它的统治地位会瓦解,不再是唯一的流量入口

核心矛盾:中心化平台的商业模式,天然会慢慢压榨上面的创作者和商户。平台既是 “商场物业”,又下场做买卖,规则由它制定,这是结构性问题,不是某一家公司好坏的问题人民日报。

平台没落之后,普通人、商户会用什么?(不是单一新产品,是好几条路线并行)

不会出现一个 “超级 APP 取代所有平台”,那只是换一个新垄断。未来是混合生态,下面四条会同时存在:

1、「自建阵地 + AI 低代码」:老网站的回归,但门槛大幅降低

以前建网站要懂代码,未来靠 AI,普通人、小商户可以几分钟生成自己独立站点、独立店铺,自己掌握域名、客户数据、商品库。

  • 商户拥有自己的客户资料、商品、粉丝,平台不再能随便封店、拿走用户。
  • 不再靠平台施舍流量,通过开放网络被搜索、被 AI 检索到。
  • 网站不会消失,角色会改变:不再是人天天点开浏览,更多变成给 AI 智能体读取的 “数字库房”,AI 帮人从无数独立站点里面找商品、找内容36氪。

简单理解:重回自己开店,而不是租别人商场的摊位,但开店的技术成本被 AI 抹平

2、联邦 / 开放协议网络(分布式网络):没有唯一老板的 “类平台”

类似 Mastodon、ActivityPub 这类联邦协议,不是一家公司掌控整个网络,是很多独立服务器互相打通,信息互通但不归单一企业控制。

  • 可以开自己的实例、自己的店铺,同时可以和全网互通;
  • 没有某一个巨头单方面改规则、强制抽高额佣金;
  • 缺点:需要基础运维,普通大众普及会慢,更适合创作者、中小商家。

不是完全没有中介,中介变成很多分散小服务商,而不是一家独大。

3、AI 智能体(Agent)成为新中间层,这是影响最大的变化财新网

现在逻辑:人打开 APP / 平台 → 在平台内部搜索消费

未来逻辑:人对 AI 说话提需求,AI 智能体去全网到处找资源,不再局限于某一个平台内部

举个商户场景:

买家说:“帮我找河北产地性价比高的某产品”,AI 会自动去无数独立商户站点、分布式网络检索比价,不再必须跳转到某一个电商大平台内部

  • 大平台仍然可以作为众多数据源之一,但不再垄断入口;
  • 商户不需要花钱买平台内部的竞价流量,只要自己的数字店铺数据对 AI 开放,就有机会被找到;
  • 风险:AI 公司会成为新的权力中心,如果少数几家大模型垄断,会形成新一轮垄断。所以会同时发展本地端侧 AI(跑在你自己手机、本地设备上),减少对少数大模型服务商依赖。

4、Web3 分布式主权网络(理想方向,但现实限制很大)

核心理念:账号、粉丝、交易记录归用户,数据分布式存储,平台不能随意删除没收你的资产。

但现实短板很明显:使用门槛高、性能、监管、诈骗问题,短期很难成为普通老百姓主流工具,更多是补充,不会成为大众日常互联网。

终端设备:以后人们拿什么上网?

  • 手机不会消失,依然是基础终端;
  • PC 继续存在,专业创作、商户经营离不开;
  • AR 眼镜、各类穿戴设备逐步普及,交互从 “点屏幕” 变成说话对话为主,打开 APP 这个行为变少,更多直接和 AI 对话完成任务。

现实的真实局面:不会完全颠覆,是 “并存”

  1. 传统大平台不会死掉,会转型。从 “垄断流量收高额地租”,变成可选服务商之一,商户可以选择入驻,也可以选择不入驻,自己独立建站做生意。
  2. 不会一步跳到完全去中心化乌托邦。监管、算力成本、普通人的使用习惯,都会约束变革速度。
  3. 会形成三类选择:
    • 嫌省事:继续用大平台(接受它的规则和抽成)
    • 想要自主权:AI 搭建自己独立站点,对接全网 AI 检索
    • 技术爱好者:联邦网络、分布式服务

站在商户角度总结演变链条

  • 2000 年代:自建网站,客户是自己的,难获客
  • 2010‑2025:入驻平台,获客容易,但客户不是你的,规则别人定
  • 未来:自己拥有店铺和客户,AI 帮你解决获客问题;平台只是众多渠道其中一个,而不是唯一必经之路

从此,在互联网拥有一方属于自己的小天地

终于,把 sunxiaogang.com 这方小小的域名落地成了自己的个人博客。

很早之前就有一个心愿,在纷繁嘈杂的互联网里,拥有一块完全属于自己的净土。没有算法推送,没有流量焦虑,没有刻意的人设包装,只用最简单、最真实的文字,记录生活、沉淀所学、留存成长。

互联网的记忆总是短暂的。朋友圈会被刷屏,社交平台的动态会被淹没,碎片化的感悟转瞬就会遗忘。而个人博客,是属于自己的、永久的数字自留地。在这里,所有的思考都有归宿,所有的努力都有痕迹。

搭建这个博客的初衷,很简单,只有两件事:向内沉淀,向外记录

往后的日子里,这里会记录我工作中的技术踩坑与实战总结,把每一次调试、每一次学习、每一次突破系统化整理,让碎片化的积累变成属于自己的核心底气;也会收纳生活里的细碎感悟,读书的思考、日常的所见所闻、成长路上的迷茫与蜕变。

我始终相信,成长从来不是一蹴而就的大事,而是日复一日微小积累的叠加。坚持记录,就是对抗平庸、对抗遗忘最好的方式。

这个以自己姓名命名的网站,不止是一个博客,更是我的数字成长日记、个人知识仓库,也是我对外的一张安静名片。

未来,我会持续在这里更新:

✅ 深耕技术,记录每一次实战与复盘 ✅ 坚持阅读,沉淀每一次认知与思考 ✅ 热爱生活,留存每一份温柔与感悟 ✅ 持续精进,见证自己的每一步成长

不求流量,不求热度,只为忠于自己。

在快节奏的时代里,慢慢写,慢慢沉淀,慢慢变好。

从此,sunxiaogang.com,正式启程。

你好,未来的自己。✨

发布于:2026年07月20日